
 83.218
 2.499

Отслеживать стоит четыре группы показателей: синхронизацию с сетью, ресурсы сервера, сетевые соединения и специфичные метрики роли — для валидатора это доля пропущенных слотов. Остальное создаёт шум. Правильно настроенный мониторинг молчит, пока всё в порядке, и присылает оповещение до того, как проблема превратится в простой, а не после.
Что смотреть в первую очередь
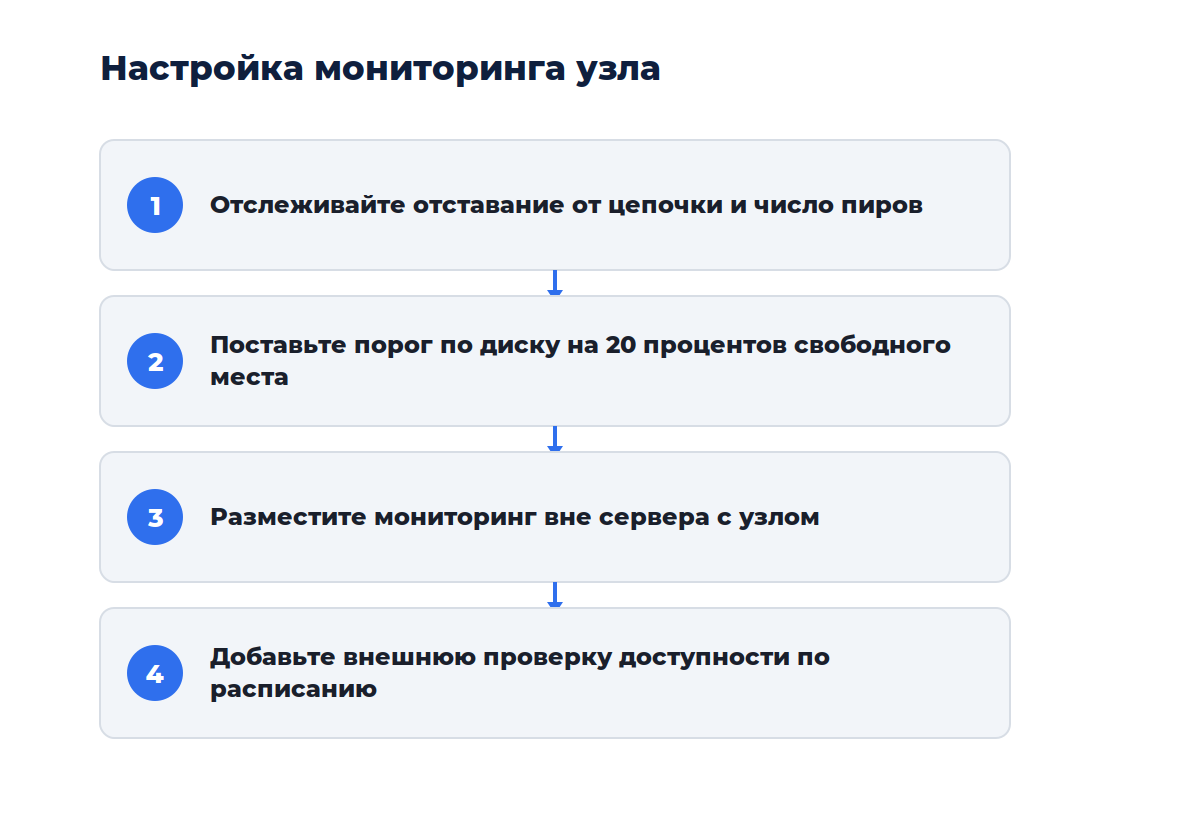
Отставание от головы цепочки — главный индикатор здоровья узла, и ноль или один блок означает норму, устойчивый рост говорит о нехватке ресурсов или проблемах с диском. Второй показатель — число подключённых пиров: падение ниже десятка указывает на сетевые ограничения или блокировку порта.
Третий блок — ресурсы сервера. Свободное место на диске, загрузка процессора и использование памяти объясняют большинство проблем с первыми двумя показателями.
Сравнение метрик по важности
| Метрика | О чём говорит и когда бить тревогу |
|---|---|
| Отставание от головы цепочки | Успевает ли узел за сетью, тревога при устойчивом росте выше нескольких блоков |
| Свободное место на диске | Самая частая причина внезапной остановки, порог оповещения — 20 процентов |
| Число подключённых пиров | Доступность узла в сети, тревога при устойчивом падении |
| Доля пропущенных слотов | Для валидатора прямо конвертируется в недополученный доход |
Как настроить оповещения
Оповещения должны приходить туда, где вы их увидите: мессенджер работает лучше почты, а настройте пороги с запасом, чтобы получать сигнал до отказа, а не в момент отказа. Для диска это двадцать процентов свободного места, для отставания — три-четыре блока подряд, для пиров — снижение вдвое от обычного уровня.
Добавьте проверку живости извне. Узел, который перестал отвечать целиком, не пришлёт оповещение сам — для этого нужен внешний сервис, пингующий его по расписанию.
Инструменты мониторинга
Большинство клиентов отдают метрики в стандартном формате, который собирают специализированные системы сбора и визуализации, при этом для одного узла это избыточно: хватает простого скрипта, опрашивающего интерфейс клиента и отправляющего сообщение при выходе за пороги. Готовые панели с графиками полезны при нескольких узлах, когда нужно видеть картину целиком.
Типовые ошибки настройки
- Оповещения на каждое мелкое отклонение: через неделю их перестают читать
- Мониторинг, работающий на том же сервере, что и узел
- Пороги, выставленные по значению отказа, а не с запасом
- Отсутствие внешней проверки доступности узла
Ко мне обращался читатель, у которого мониторинг был настроен образцово, но работал на том же сервере, причём когда сервер завис, замолчали оба — и узел, и система оповещений. Проблему он обнаружил через сутки по упавшему доходу, и внешняя проверка живости за пару минут настройки решила бы вопрос.
Метрики валидатора отдельно
Для валидатора к базовому набору добавляются показатели участия: доля выполненных обязанностей, эффективность аттестаций и баланс залога, и снижение эффективности при нормальной синхронизации обычно указывает на задержки в сети, а не на проблему самого узла.
Баланс стоит вынести в отдельное оповещение, а его уменьшение вместо роста — признак штрафов, и разбираться с этим нужно немедленно, а не в конце месяца.
Что делать по оповещению
Сначала подтвердите проблему: посмотрите журнал узла и текущие значения метрик. Часть оповещений окажется ложной из-за кратковременных всплесков, тогда как затем действуйте по типу проблемы: место на диске освобождают удалением старых журналов, рост отставания требует проверки нагрузки, падение пиров — сетевых настроек и доступности порта.
Журнал узла как источник данных
Метрики показывают состояние, журнал объясняет причину. При разборе проблемы начинают именно с него: записи об ошибках подключения, отказах записи на диск и перезапусках службы появляются раньше, чем метрика выйдет за порог.
Настройте ротацию журналов. Без неё они сами заполняют диск и становятся причиной той самой остановки, которую должны были помочь предотвратить.
Ведение истории показателей
Разовые значения мало что говорят. Графики за недели показывают тенденции: постепенный рост потребления диска подскажет, когда потребуется расширение, а медленное увеличение отставания укажет, что сервер перестаёт справляться с нагрузкой, и храните историю хотя бы за месяц. Этого достаточно для планирования расширения и оценки запаса по производительности.
Смежные темы разобраны у нас. Вот основные. Общий раздел — майнинг и инфраструктура. Шире — статьи про криптокошельки. Резервирование разбирает материал как обеспечить бесперебойную работу узла, а порядок обновлений — статья как обновлять программное обеспечение узла.
Вопросы и ответы
Сколько метрик достаточно для одного узла?
Четырёх-пяти хватает: отставание от цепочки, свободное место, число пиров, доступность узла извне и для валидатора доля пропущенных слотов, при этом остальное собирают, но не выводят в оповещения. Избыток сигналов приводит к тому, что их перестают замечать, и это опаснее отсутствия мониторинга.
Где размещать систему мониторинга?
Обязательно вне сервера с узлом. Подойдёт дешёвый виртуальный сервер, домашний мини-компьютер или внешний сервис проверки доступности, причём правило простое: если узел и мониторинг падают вместе, мониторинга у вас нет.
Как отличить ложное оповещение от реальной проблемы?
По устойчивости отклонения. Кратковременный всплеск отставания при высокой нагрузке сети — норма, тот же рост в течение получаса — повод разбираться, и поэтому пороги задают не по мгновенному значению, а по длительности состояния: три-четыре замера подряд вместо одного.
Вердикт
Мониторинг нужен не ради графиков, а чтобы узнать о проблеме раньше, чем она станет простоем, а четырёх метрик достаточно, а избыток оповещений превращает их в фон, который перестают читать. Главное правило одно: система контроля живёт отдельно от того, что контролирует. Свободное место на диске остаётся самой частой причиной внезапных остановок, и порог по нему выставляют с запасом.
Технические требования сверяйте напрямую. Руководство ethereum.org по самостоятельному стейкингу и инструкция по запуску полного узла биткоина описывают штатные интерфейсы получения метрик.

Обсуждение
Добавить комментарий